04 · LoRA: el mismo ajuste moviendo el 3,5 % de los pesos
Demo rápida — Deep Learning para Business Analytics · Comillas ICADE
En el cuaderno 03 movimos los 134 millones de pesos de SmolLM2 para enseñarle a rellenar una ficha de CRM. Funcionó, y dejó tres facturas:
- el optimizador Adam tuvo que guardar dos números más por cada peso (el momento y el momento segundo), que es donde se va de verdad la memoria de entrenamiento;
- el resultado ocupa 518 MB en disco, uno por cada tarea que quieras resolver;
- el modelo olvidó casi todo lo que sabía hacer antes.
LoRA (Low-Rank Adaptation, Hu et al., 2021) resuelve las tres de un golpe con una observación muy simple: la actualización que necesitas aplicar a una matriz de pesos para especializarla en una tarea es de rango bajo. No necesitas 1.536 × 1.536 números libres para describirla; te bastan dos matrices flacas.
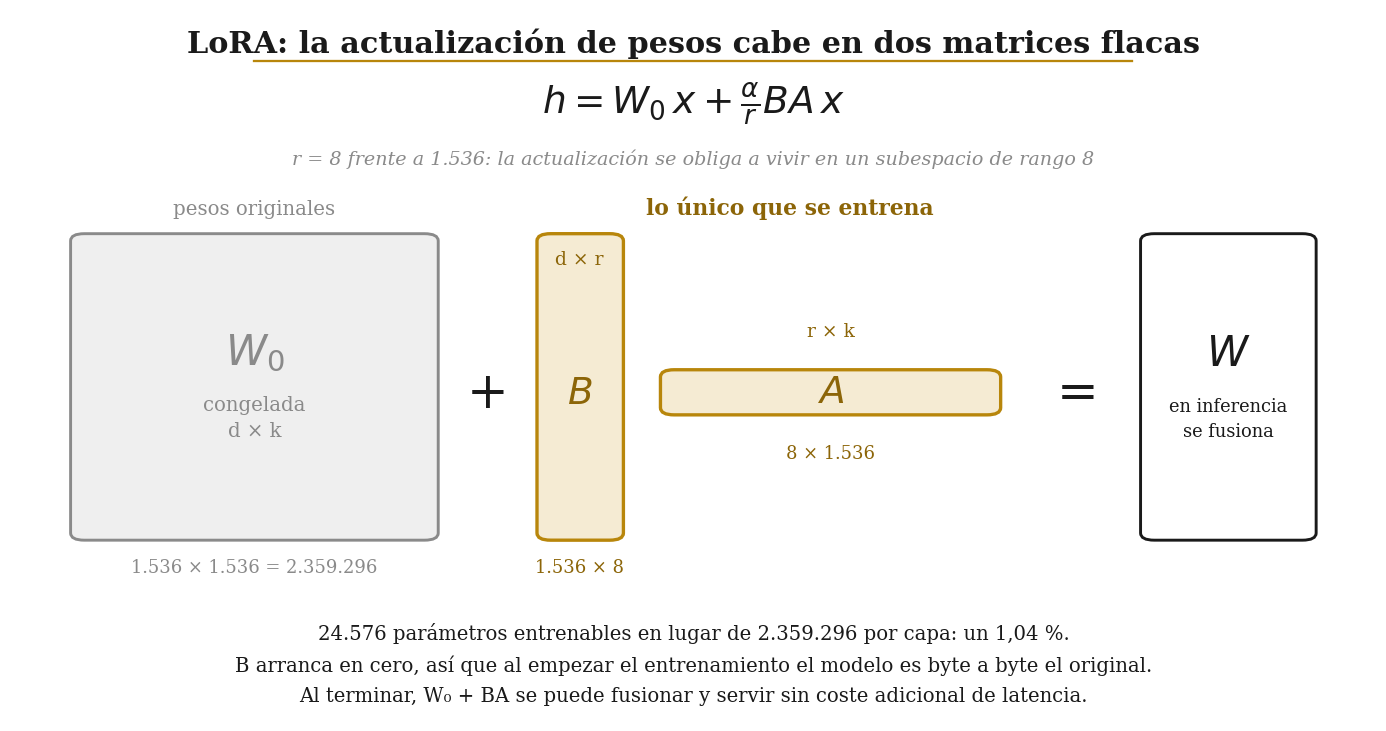
En lugar de entrenar $W$, se congela $W_0$ y se entrena $B \in \mathbb{R}^{d \times r}$ y $A \in \mathbb{R}^{r \times k}$ con $r$ pequeño (8, 16, 64):
$$h = W_0\,x + \frac{\alpha}{r}\,B\,A\,x$$
Dos detalles que hacen que esto funcione y no son decorativos:
- $B$ se inicializa a cero y $A$ con ruido gaussiano. Al empezar, $BA = 0$, así que el modelo es byte a byte el original. El entrenamiento arranca sin perturbación.
- $\alpha/r$ es un reescalado para que cambiar $r$ no obligue a recalibrar la tasa de aprendizaje. Lo habitual es $\alpha = 2r$.
Antes de nada: preparar el ordenador
Ejecuta la celda de abajo antes que ninguna otra. Mira qué sistema operativo tienes y qué hay ya instalado, y descarga solo lo que falte: funciona igual en Windows, en macOS y en Linux, y no hace falta que instales nada a mano.
La primera vez tarda unos minutos, porque se baja PyTorch. Las siguientes termina en un segundo. Se puede ejecutar tantas veces como quieras.
Si algo falla, cambia instalar() por instalar(verboso=True), vuelve a
ejecutarla y enseña lo que imprima.
# Prepara el entorno: comprueba lo que ya tienes e instala únicamente lo que
# falte. Si ya está todo, no descarga nada.
import sys
from pathlib import Path

_aqui = Path.cwd()
_candidatas = [_aqui, *_aqui.parents,                       # lo normal
               *(f.parents[1] for f in _aqui.glob("*/comun/entorno.py")),
               *(f.parents[1] for f in _aqui.glob("*/*/comun/entorno.py"))]
_raiz = next((p for p in _candidatas
              if (p / "comun" / "entorno.py").is_file()), None)
if _raiz is None:
    raise RuntimeError(
        "No encuentro la carpeta 'comun'. Descomprime el zip entero y abre "
        "este cuaderno desde dentro de la carpeta demo_rapida.")
sys.path.insert(0, str(_raiz))

from comun.entorno import instalar, preparar

instalar()                 # ¿algo ha fallado? -> instalar(verboso=True)
_carpeta = preparar()      # deja las rutas del cuaderno listas
Entorno listo, no hay nada que instalar. (Linux 6.8.0-138-generic · Python 3.10.12)
import random
import time
from pathlib import Path

import torch
import torch.nn as nn

from comun.config import MODELO_PEQUE, DTYPE_ENTRENO, DEVICE, fijar_semilla, mil, cronometro, resumen_entorno
from comun.datos import triaje, triaje_dificil, INSTRUCCION_TRIAJE
from comun.entrenamiento import construir_lote, generar, medir

resumen_entorno()
fijar_semilla()
Sistema        : Linux 6.8.0-138-generic (x86_64)
Python         : 3.10.12
PyTorch        : 2.14.1+cpu
Dispositivo    : cpu
Hilos de CPU   : 8
Sin GPU: todo funciona igual, solo que más despacio.
Semilla        : 0
1. Una capa LoRA escrita a mano
Antes de usar la biblioteca, veinte líneas. Lo único que hay que entender de LoRA está aquí.
class LinealLoRA(nn.Module):
    """Envuelve una nn.Linear congelada y le suma una corrección de rango r.

    Shapes:
        entrada: (batch, ..., k)
        salida : (batch, ..., d)
        A: (r, k)   B: (d, r)   -> BA: (d, k), igual que W0
    """

    def __init__(self, base: nn.Linear, r: int = 8, alpha: int = 16):
        super().__init__()
        self.base = base
        for p in self.base.parameters():
            p.requires_grad = False            # W0 congelada

        d, k = base.out_features, base.in_features
        self.A = nn.Parameter(torch.empty(r, k))
        self.B = nn.Parameter(torch.zeros(d, r))   # cero: BA = 0 al empezar
        nn.init.normal_(self.A, std=1 / r)
        self.escala = alpha / r

    def forward(self, x):
        return self.base(x) + self.escala * (x @ self.A.T) @ self.B.T


# Comprobación 1: al nacer, la capa LoRA es indistinguible de la original.
fijar_semilla()
base = nn.Linear(64, 128)
capa = LinealLoRA(base, r=8, alpha=16)
x = torch.randn(4, 10, 64)

with torch.no_grad():
    assert torch.allclose(capa(x), base(x), atol=1e-6), "B no estaba a cero"
print("ok · con B = 0 la salida es idéntica a la del modelo original")

# Comprobación 2: con B distinto de cero, la corrección tiene rango como mucho r.
with torch.no_grad():
    capa.B.normal_(std=0.02)
    delta = capa.escala * capa.B @ capa.A
rango = torch.linalg.matrix_rank(delta).item()
print(f"ok · forma de la corrección {tuple(delta.shape)}, rango = {rango} (r = 8)")

n_base = sum(p.numel() for p in base.parameters())
n_lora = capa.A.numel() + capa.B.numel()
print(f"\nparámetros de W0 y el sesgo : {mil(n_base)}")
print(f"parámetros de A y B         : {mil(n_lora)}   ({100 * n_lora / n_base:.1f} %)")
print("\nAquí LoRA no ahorra: con d=128 y k=64, un rango 8 ya es una fracción gorda.")
print("El ahorro es r(d+k) frente a dk, así que crece con el tamaño de la matriz:")
for d, k in [(128, 64), (576, 576), (1536, 1536), (4096, 4096), (8192, 8192)]:
    r = 8
    print(f"   {d:5d} x {k:<5d}  ->  {100 * r * (d + k) / (d * k):5.1f} %")
ok · con B = 0 la salida es idéntica a la del modelo original
ok · forma de la corrección (128, 64), rango = 8 (r = 8)

parámetros de W0 y el sesgo : 8.320
parámetros de A y B         : 1.536   (18.5 %)

Aquí LoRA no ahorra: con d=128 y k=64, un rango 8 ya es una fracción gorda.
El ahorro es r(d+k) frente a dk, así que crece con el tamaño de la matriz:
     128 x 64     ->   18.8 %
     576 x 576    ->    2.8 %
    1536 x 1536   ->    1.0 %
    4096 x 4096   ->    0.4 %
    8192 x 8192   ->    0.2 %
2. Ahora con peft, que es lo que se usa
peft (Hugging Face) hace esto mismo recorriendo el modelo y sustituyendo por nombre los módulos
que le digas. Lo que hay que decidir es cuáles.
from peft import LoraConfig, get_peft_model
from transformers import AutoModelForCausalLM, AutoTokenizer

tok = AutoTokenizer.from_pretrained(MODELO_PEQUE)
base = AutoModelForCausalLM.from_pretrained(MODELO_PEQUE, dtype=DTYPE_ENTRENO)

print("Módulos lineales de un bloque (los candidatos a llevar LoRA):\n")
for nombre, m in base.named_modules():
    if nombre.startswith("model.layers.0.") and isinstance(m, nn.Linear):
        papel = {"q_proj": "consulta de la atención", "k_proj": "clave de la atención",
                 "v_proj": "valor de la atención", "o_proj": "salida de la atención",
                 "gate_proj": "puerta del MLP", "up_proj": "expansión del MLP",
                 "down_proj": "contracción del MLP"}.get(nombre.split(".")[-1], "")
        print(f"  {nombre:42s} {m.in_features:>5d} -> {m.out_features:<5d}  {papel}")
/tmp/venv_demo/lib/python3.10/site-packages/tqdm/auto.py:21: TqdmWarning: IProgress not found. Please update jupyter and ipywidgets. See https://ipywidgets.readthedocs.io/en/stable/user_install.html
  from .autonotebook import tqdm as notebook_tqdm
Módulos lineales de un bloque (los candidatos a llevar LoRA):

  model.layers.0.self_attn.q_proj              576 -> 576    consulta de la atención
  model.layers.0.self_attn.k_proj              576 -> 192    clave de la atención
  model.layers.0.self_attn.v_proj              576 -> 192    valor de la atención
  model.layers.0.self_attn.o_proj              576 -> 576    salida de la atención
  model.layers.0.mlp.gate_proj                 576 -> 1536   puerta del MLP
  model.layers.0.mlp.up_proj                   576 -> 1536   expansión del MLP
  model.layers.0.mlp.down_proj                1536 -> 576    contracción del MLP
ATENCION = ["q_proj", "k_proj", "v_proj", "o_proj"]
TODO = ATENCION + ["gate_proj", "up_proj", "down_proj"]

config = LoraConfig(
    r=16,                      # rango de la corrección
    lora_alpha=32,             # el alpha de la fórmula; la convención es 2r
    lora_dropout=0.05,
    bias="none",               # los sesgos no se tocan
    task_type="CAUSAL_LM",
    target_modules=TODO,       # prueba con ATENCION en el ejercicio 4.2
)

fijar_semilla()
mod = get_peft_model(
    AutoModelForCausalLM.from_pretrained(MODELO_PEQUE, dtype=DTYPE_ENTRENO), config).to(DEVICE)
mod.print_trainable_parameters()

entrenables = [p for p in mod.parameters() if p.requires_grad]
congelados = [p for p in mod.parameters() if not p.requires_grad]
n_e = sum(p.numel() for p in entrenables)
n_c = sum(p.numel() for p in congelados)
print(f"\ncongelados  : {mil(n_c):>14s}")
print(f"entrenables : {mil(n_e):>14s}   ({100 * n_e / (n_e + n_c):.2f} %)")
print(f"\nMemoria del estado de Adam (2 números float32 por peso entrenable):")
print(f"  SFT completo : {n_c * 2 * 4 / 1024**2:7.0f} MB")
print(f"  LoRA         : {n_e * 2 * 4 / 1024**2:7.0f} MB")
trainable params: 4,884,480 || all params: 139,399,488 || trainable%: 3.5039

congelados  :    134.515.008
entrenables :      4.884.480   (3.50 %)

Memoria del estado de Adam (2 números float32 por peso entrenable):
  SFT completo :    1026 MB
  LoRA         :      37 MB
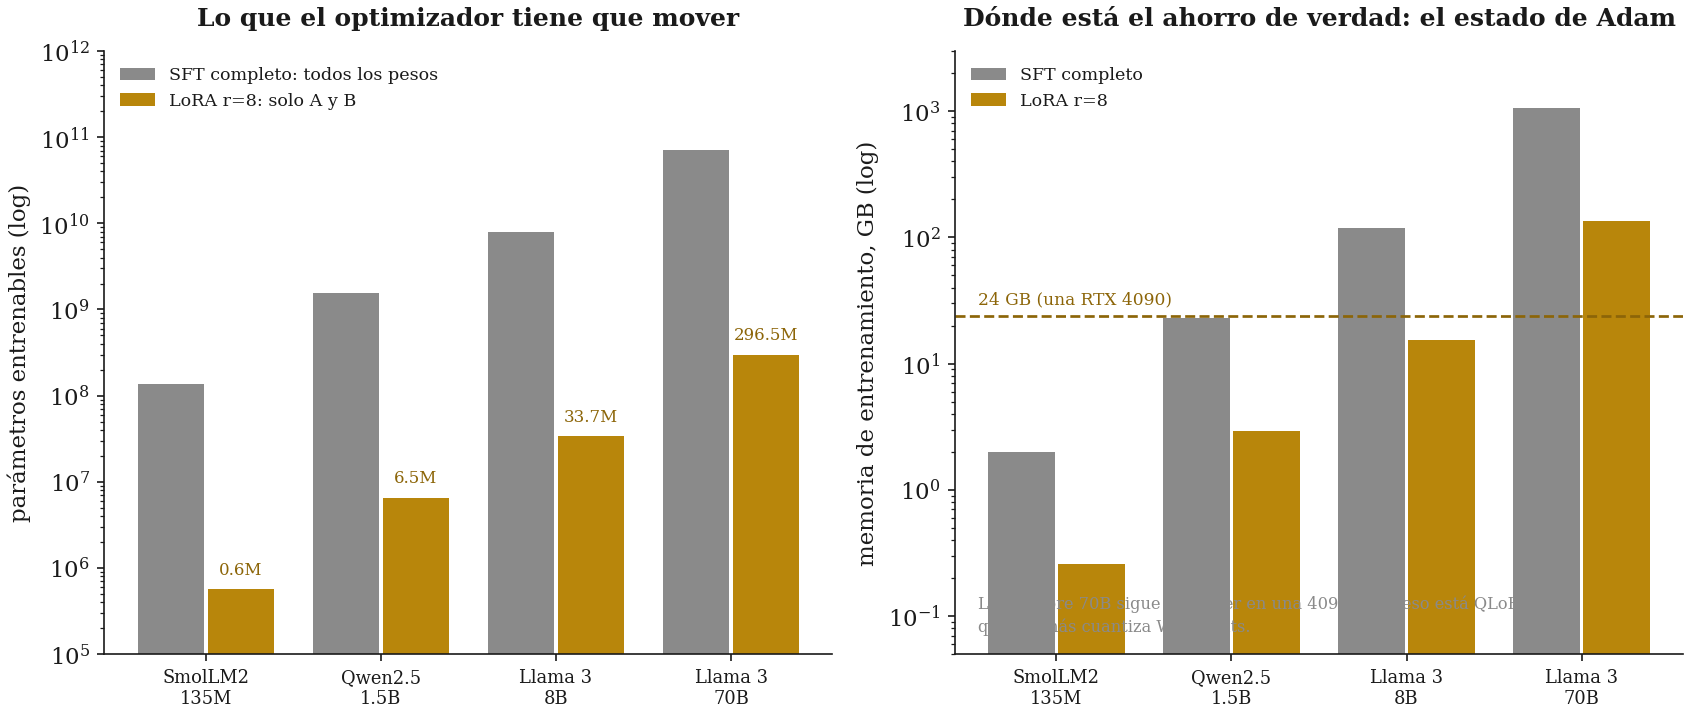
El panel de la derecha es el que explica por qué LoRA se usa en todas partes. Con Adam en precisión mixta hacen falta unos 16 bytes por parámetro entrenable (pesos en fp16, copia maestra en fp32, gradiente y los dos momentos). Sobre un modelo de 8 B eso son 120 GB, que no caben en ninguna GPU de consumo. Con LoRA, los pesos congelados solo necesitan sus 2 bytes de lectura y los 16 bytes se pagan únicamente sobre el 3,5 % entrenable.
Lo que no ahorra LoRA es cómputo del paso hacia delante ni del paso hacia atrás: el gradiente sigue teniendo que atravesar toda la red para llegar a las capas de abajo. Lo verás en el reloj dentro de un momento.
3. Entrenar
Mismo bucle que en el cuaderno 03, mismos datos, misma métrica. Dos diferencias: el optimizador
solo recibe los parámetros entrenables, y la tasa de aprendizaje sube un orden de magnitud
(5e-4 frente a 5e-5), porque A y B parten de cero y tienen que recorrer más camino.
train, test = triaje(n_train=160, n_test=40)
dificil = triaje_dificil()

with cronometro("evaluar antes"):
    antes = generar(mod, tok, test, INSTRUCCION_TRIAJE, max_new_tokens=40)
print("\nANTES:", medir(antes, test))
[evaluar antes] 15.0 s

ANTES: formato   0.0%   categoría   0.0%   ficha exacta   0.0%   (n=40)
BATCH, EPOCAS, LR = 4, 3, 5e-4

optimizador = torch.optim.AdamW(entrenables, lr=LR)
perdidas = []
mod.train()

t0 = time.time()
for epoca in range(EPOCAS):
    random.shuffle(train)
    for i in range(0, len(train), BATCH):
        X, A, Y = construir_lote(tok, train[i:i + BATCH], INSTRUCCION_TRIAJE)
        X, A, Y = X.to(DEVICE), A.to(DEVICE), Y.to(DEVICE)
        salida = mod(input_ids=X, attention_mask=A, labels=Y)
        salida.loss.backward()
        torch.nn.utils.clip_grad_norm_(entrenables, 1.0)
        optimizador.step()
        optimizador.zero_grad()
        perdidas.append(salida.loss.item())
    n = len(train) // BATCH
    print(f"época {epoca + 1}/{EPOCAS}   pérdida media {sum(perdidas[-n:]) / n:.4f}   "
          f"[{time.time() - t0:.0f} s]")

segundos_lora = time.time() - t0
época 1/3 pérdida media 0.2761 [110 s]
época 2/3 pérdida media 0.0330 [218 s]
época 3/3 pérdida media 0.0071 [328 s]
with cronometro("evaluar después"):
    despues = generar(mod, tok, test, INSTRUCCION_TRIAJE, max_new_tokens=40)
    duro = generar(mod, tok, dificil, INSTRUCCION_TRIAJE, max_new_tokens=40)

print(f"\ntest de plantilla : {medir(despues, test)}")
print(f"escrito a mano    : {medir(duro, dificil)}")
[evaluar después] 20.8 s

test de plantilla : formato 100.0%   categoría 100.0%   ficha exacta 100.0%   (n=40)
escrito a mano    : formato 100.0%   categoría  75.0%   ficha exacta  75.0%   (n=12)
4. La comparación, con los números medidos
Esta tabla está medida en el portátil de referencia (CPU, 8 hilos, mismos datos, misma semilla, 3 épocas). Tus tiempos cambiarán; las proporciones, no.
| parámetros entrenables | % | tiempo de entrenamiento | ficha exacta (test) | ficha exacta (a mano) | |
|---|---|---|---|---|---|
SFT completo, lr 5e-5 |
134.515.008 | 99,3 % | 335 s | 100 % | 66,7 % |
LoRA r=16, atención + MLP, lr 5e-4 |
4.884.480 | 3,5 % | 302 s | 100 % | 75,0 % |
LoRA r=8, solo atención, lr 3e-4 |
921.600 | 0,68 % | 268 s | 77,5 % | 41,7 % |
Tres lecturas:
LoRA con rango y módulos suficientes alcanza al SFT completo. Con r=16 sobre atención y MLP,
el 3,5 % de los parámetros basta para la misma ficha exacta en test.
El rango y los módulos elegidos importan más que el rango solo. La tercera fila, con r=8 y
solo las proyecciones de atención, se queda a medio camino. La recomendación práctica del campo es
poner LoRA en todas las capas lineales antes que subir mucho el rango.
En CPU, LoRA no ahorra tiempo. 302 s frente a 335 s. El ahorro de LoRA es de memoria, no de cómputo: el paso hacia atrás sigue recorriendo la red entera. En GPU, donde la memoria es el cuello de botella real, ese ahorro es lo que decide si el entrenamiento cabe o no cabe.
Sobre la última columna conviene no sacar pecho: 75 % frente a 66,7 % en un conjunto de 12 ejemplos son 9 aciertos frente a 8. Es consistente con la idea de que LoRA regulariza (menos parámetros libres, menos capacidad de memorizar las plantillas), pero con esa n no demuestra nada. Está en los ejercicios medirlo con muestra suficiente.
5. Fusionar: en inferencia, LoRA es gratis
$W_0 + \frac{\alpha}{r} BA$ es una matriz del mismo tamaño que $W_0$. Se puede calcular una vez y guardar el resultado. El modelo fusionado es un modelo normal: misma arquitectura, misma latencia, ningún rastro de que se entrenó con LoRA.
# Antes de fusionar, nos quedamos con una salida de referencia.
mod.eval()
sonda = [{"entrada": test[0]["entrada"], "salida": ""}]
X, A, _ = construir_lote(tok, [{"entrada": test[0]["entrada"], "salida": "x"}], INSTRUCCION_TRIAJE)
with torch.no_grad():
    logits_lora = mod(input_ids=X.to(DEVICE), attention_mask=A.to(DEVICE)).logits

with cronometro("fusionar"):
    fusionado = mod.merge_and_unload()

with torch.no_grad():
    logits_fus = fusionado(input_ids=X.to(DEVICE), attention_mask=A.to(DEVICE)).logits

dif = (logits_lora - logits_fus).abs().max().item()
print(f"\nMáxima diferencia en los logits tras fusionar: {dif:.2e}")
assert dif < 1e-3, "la fusión ha cambiado el modelo"
print("ok · el modelo fusionado calcula lo mismo (la diferencia es ruido de coma flotante)")

print(f"\nTipo tras fusionar: {type(fusionado).__name__}")
print("Ya no hay capas LoRA: es un LlamaForCausalLM normal y corriente.")
[fusionar] 0.1 s

Máxima diferencia en los logits tras fusionar: 1.31e-04
ok · el modelo fusionado calcula lo mismo (la diferencia es ruido de coma flotante)

Tipo tras fusionar: LlamaForCausalLM
Ya no hay capas LoRA: es un LlamaForCausalLM normal y corriente.
# Y lo que de verdad cambia la operación: lo que ocupa cada cosa en disco.
destino = Path("modelos/lora_triaje")
destino.mkdir(parents=True, exist_ok=True)

fijar_semilla()
copia = get_peft_model(
    AutoModelForCausalLM.from_pretrained(MODELO_PEQUE, dtype=DTYPE_ENTRENO), config)
copia.load_state_dict({k: v for k, v in mod.state_dict().items()}, strict=False)
copia.save_pretrained(destino)

mb_adaptador = sum(f.stat().st_size for f in destino.rglob("*")) / 1024**2
mb_sft = 518.0        # lo que ocupó el modelo completo del cuaderno 03

print(f"adaptador LoRA      : {mb_adaptador:7.1f} MB")
print(f"modelo del SFT (03) : {mb_sft:7.1f} MB")
print(f"ratio               : {mb_sft / max(mb_adaptador, 0.1):7.0f}×\n")
print(f"{'tareas':>8s} {'un modelo por tarea':>22s} {'base + N adaptadores':>24s}")
print("-" * 58)
for n in (1, 10, 100, 1000):
    print(f"{n:8d} {n * mb_sft / 1024:19.1f} GB {(mb_sft + n * mb_adaptador) / 1024:21.1f} GB")
print("\nEsta tabla es el modelo de negocio entero de los proveedores que ofrecen")
print("'fine-tuning' barato: una sola copia del modelo en memoria y un adaptador")
print("por cliente, intercambiable en milisegundos.")
adaptador LoRA      :    18.7 MB
modelo del SFT (03) :   518.0 MB
ratio               :      28×

  tareas    un modelo por tarea     base + N adaptadores
----------------------------------------------------------
       1                 0.5 GB                   0.5 GB
      10                 5.1 GB                   0.7 GB
     100                50.6 GB                   2.3 GB
    1000               505.9 GB                  18.8 GB

Esta tabla es el modelo de negocio entero de los proveedores que ofrecen
'fine-tuning' barato: una sola copia del modelo en memoria y un adaptador
por cliente, intercambiable en milisegundos.
6. QLoRA, en una línea
El panel derecho de la figura del apartado 2 enseña que LoRA sobre un modelo de 70 B todavía pide unos 130 GB: los pesos congelados hay que tenerlos en algún sitio.
QLoRA (Dettmers et al., 2023) añade la pieza que falta: cuantizar $W_0$ a 4 bits y dejar
A y B en 16 bits. Los pesos congelados pasan a ocupar la cuarta parte y el entrenamiento de un
modelo de 70 B cabe en una sola GPU de 48 GB. En peft se activa cargando el modelo con
BitsAndBytesConfig(load_in_4bit=True) y llamando a prepare_model_for_kbit_training.
Aquí no lo ejecutamos porque bitsandbytes necesita CUDA, pero es literalmente el mismo código
con dos líneas más.
7. Ejercicios
4.1 Barre el rango en {2, 4, 8, 16, 64} con los mismos módulos y mide ficha exacta en los
dos conjuntos, parámetros entrenables y tiempo. Dibuja la curva. ¿Dónde satura?
4.2 Repite el entrenamiento con target_modules=ATENCION y con TODO, a igualdad de
parámetros entrenables (sube el rango en el primero hasta igualar). ¿Importa más dónde pones LoRA
o cuántos parámetros le das?
4.3 La afirmación "LoRA generaliza mejor porque regulariza" está sin demostrar con n = 12. Amplía el conjunto escrito a mano a 60 incidencias, reentrena los dos métodos con 5 semillas y decide con un test estadístico si la diferencia se sostiene.
4.4 Entrena DOS adaptadores sobre la misma base: el de triaje y otro que responda siempre en
inglés. Cárgalos los dos con load_adapter y alterna entre ellos con set_adapter. Mide el
tiempo de cambio y compáralo con cargar dos modelos completos.
4.5 Vuelve al experimento de olvido catastrófico del cuaderno 03 (apartado 7) con el modelo
LoRA. ¿Olvida menos? Y, lo que es más útil: desactiva el adaptador con
with mod.disable_adapter(): y comprueba que el modelo base sigue intacto. Ese es el argumento
operativo más fuerte de LoRA.
4.6 Implementa el entrenamiento del modelo con tu clase LinealLoRA en lugar de peft:
recorre named_modules(), sustituye los q_proj y v_proj por LinealLoRA(...) y entrena.
Comprueba que llegas a métricas parecidas. Es la mejor manera de convencerte de que peft no
hace magia.