00 · Bajarse un modelo libre y mirarlo por dentro
Demo rápida — Deep Learning para Business Analytics · Comillas ICADE
Cinco técnicas, una sola historia. Trabajamos para Banco Iberia, un banco inventado que tiene su normativa, sus clientes y su buzón de incidencias. Vamos a coger un modelo de lenguaje de pesos abiertos y a hacerle las cinco cosas que se le hacen a un modelo en una empresa.
| Cuaderno | Qué le hacemos al modelo | ¿Se tocan los pesos? | |
|---|---|---|---|
| 1 | 01_rag |
le damos los documentos buenos en el prompt | no |
| 2 | 02_mcp |
le damos herramientas que ejecutan código | no |
| 3 | 03_sft |
le enseñamos una tarea con ejemplos resueltos | sí, todos |
| 4 | 04_lora |
lo mismo, moviendo el 3,5 % de los pesos | sí, unos pocos |
| 5 | 05_rlhf |
lo movemos hacia lo que las personas prefieren | sí, con un juez aprendido |
Este cuaderno es el punto de partida: descargar, abrir y entender qué es exactamente eso que hemos descargado.
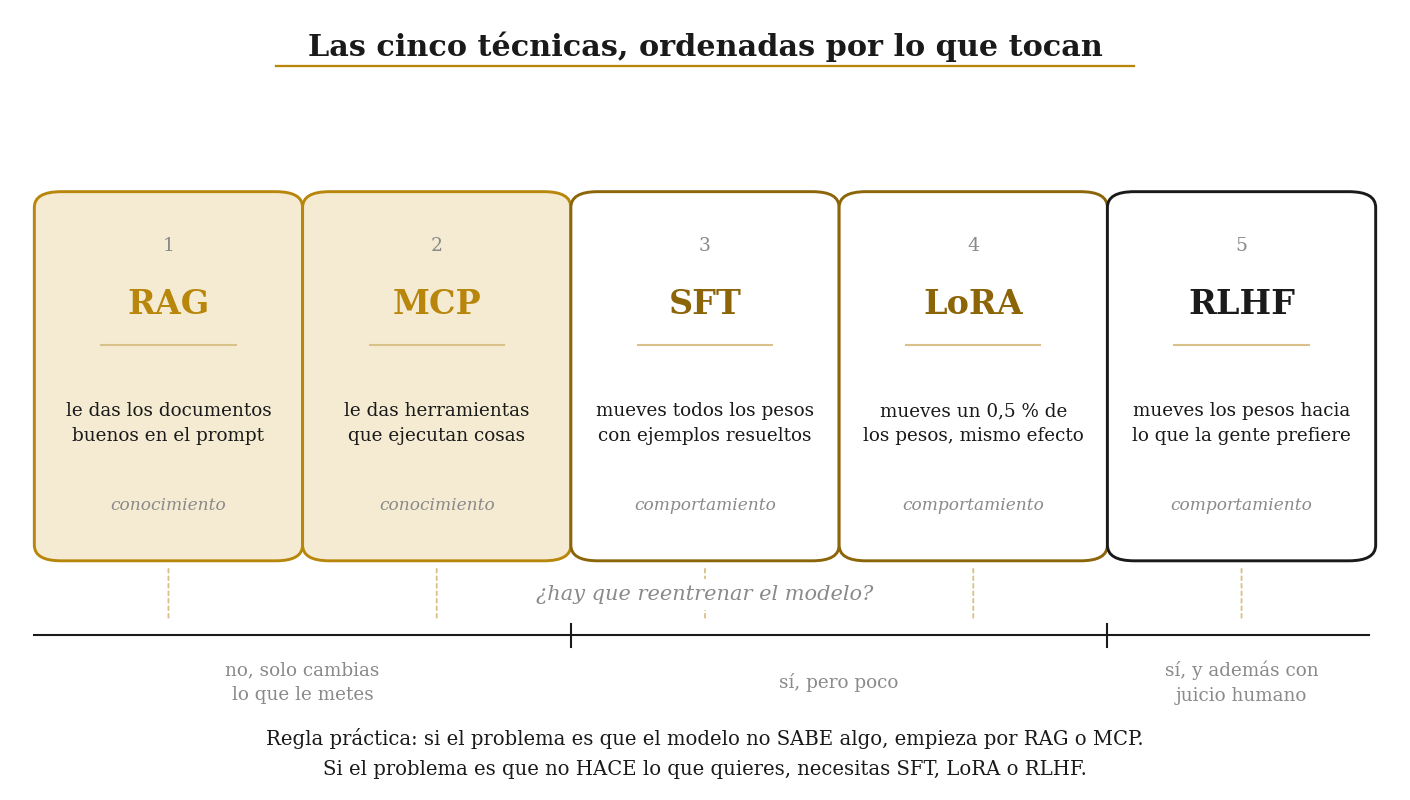
La pregunta que ordena todo el curso de hoy es ésta: ¿el modelo falla porque no SABE algo, o porque no HACE lo que quieres?
Si no sabe algo (la comisión de tu banco, el inventario de hoy, el contrato que firmasteis ayer), reentrenarlo es la respuesta cara y mala. Le das el dato: RAG o MCP.
Si sabe de sobra pero responde en un formato que no te sirve, con un tono que no es el de tu marca o saltándose tu procedimiento, entonces sí hay que mover pesos: SFT, LoRA, RLHF.
1. Qué necesitas
Nada instalado de antemano. La celda siguiente se encarga: comprueba qué tienes y baja lo que falte, sea cual sea tu sistema operativo. Lo mismo vale en Google Colab.
Hardware: todo está preparado para funcionar en CPU con unos 6 GB de RAM libres. Con GPU va mucho más rápido y no hay que cambiar nada, porque el código detecta el dispositivo solo. Los tiempos que aparecen comentados en los cuadernos están medidos en un portátil sin GPU, con 8 hilos.
# Prepara el entorno: comprueba lo que ya tienes e instala únicamente lo que
# falte. Si ya está todo, no descarga nada.
import sys
from pathlib import Path

_aqui = Path.cwd()
_candidatas = [_aqui, *_aqui.parents,                       # lo normal
               *(f.parents[1] for f in _aqui.glob("*/comun/entorno.py")),
               *(f.parents[1] for f in _aqui.glob("*/*/comun/entorno.py"))]
_raiz = next((p for p in _candidatas
              if (p / "comun" / "entorno.py").is_file()), None)
if _raiz is None:
    raise RuntimeError(
        "No encuentro la carpeta 'comun'. Descomprime el zip entero y abre "
        "este cuaderno desde dentro de la carpeta demo_rapida.")
sys.path.insert(0, str(_raiz))

from comun.entorno import instalar, preparar

instalar()                 # ¿algo ha fallado? -> instalar(verboso=True)
_carpeta = preparar()      # deja las rutas del cuaderno listas
Entorno listo, no hay nada que instalar. (Linux 6.8.0-138-generic · Python 3.10.12)
from comun.config import (MODELO_CHARLA, MODELO_PEQUE, MODELO_EMBED, DEVICE,
                          DTYPE_CHARLA, DTYPE_ENTRENO, fijar_semilla, mil,
                          resumen_entorno, tam_mb, cronometro)

resumen_entorno()
fijar_semilla()
Sistema        : Linux 6.8.0-138-generic (x86_64)
Python         : 3.10.12
PyTorch        : 2.14.1+cpu
Dispositivo    : cpu
Hilos de CPU   : 8
Sin GPU: todo funciona igual, solo que más despacio.
Semilla        : 0
2. Los tres modelos de la demo
Los tres son de pesos abiertos: te los descargas, los ejecutas en tu máquina y nadie ve tus datos. Esa es la diferencia operativa con llamar a una API, y en banca o sanidad es muchas veces la diferencia entre poder hacer el proyecto y no poder.
| Modelo | Papel | Parámetros | Licencia | Dónde se usa |
|---|---|---|---|---|
Qwen/Qwen2.5-1.5B-Instruct |
conversa | 1.540 M | Apache 2.0 | cuadernos 01 y 02 |
HuggingFaceTB/SmolLM2-135M-Instruct |
se entrena | 135 M | Apache 2.0 | cuadernos 03, 04 y 05 |
intfloat/multilingual-e5-small |
vectoriza texto | 118 M | MIT | cuaderno 01 |
Apache 2.0 y MIT permiten uso comercial sin pedir permiso. No todas las licencias "abiertas" lo hacen: la familia Llama, por ejemplo, va con licencia propia y con un límite de usuarios activos. Antes de meter un modelo en un producto, el fichero que hay que leer es la licencia, no el leaderboard.
# Qué hay realmente dentro de un repositorio de Hugging Face.
from huggingface_hub import HfApi

api = HfApi()
info = api.model_info(MODELO_PEQUE, files_metadata=True)

print(f"Repositorio: {info.id}")
print(f"Licencia   : {info.cardData.get('license')}")
print(f"Descargas el último mes: {mil(info.downloads)}\n")
print(f"{'fichero':38s} {'tamaño':>10s}   para qué sirve")
print("-" * 86)
# El orden importa: se coge la PRIMERA clave que encaje, y
# "tokenizer_config.json" también acaba en "config.json".
PARA_QUE = {
    ".safetensors": "LOS PESOS. Es el modelo.",
    "tokenizer_config.json": "incluye el chat template (plantilla de conversación)",
    "generation_config.json": "valores por defecto al generar",
    "special_tokens_map.json": "tokens especiales: fin de texto, relleno...",
    "config.json": "arquitectura: capas, dimensiones, vocabulario",
    "tokenizer.json": "cómo se parte el texto en tokens",
    "vocab.json": "tabla token -> id",
    "merges.txt": "reglas de fusión del tokenizador BPE",
    "README.md": "la model card: licencia, datos de entrenamiento, limitaciones",
    "training_args.bin": "los hiperparámetros con los que lo entrenaron",
}
# Filtramos los subdirectorios: `onnx/` son conversiones a otro runtime y
# `runs/` son los logs de TensorBoard del entrenamiento original. Ninguno de
# los dos hace falta para usar el modelo desde PyTorch.
principales = [f for f in info.siblings if "/" not in f.rfilename]
for f in sorted(principales, key=lambda s: -(s.size or 0)):
    mb = (f.size or 0) / 1024**2
    clave = next((k for k in PARA_QUE if f.rfilename.endswith(k)), None)
    print(f"{f.rfilename:38s} {mb:9.1f} MB   {PARA_QUE.get(clave, '')}")

extra = [f for f in info.siblings if "/" in f.rfilename]
print(f"\n(+ {len(extra)} ficheros en subdirectorios: conversiones a ONNX y logs "
      f"del entrenamiento original, que no usamos)")
/tmp/venv_demo/lib/python3.10/site-packages/tqdm/auto.py:21: TqdmWarning: IProgress not found. Please update jupyter and ipywidgets. See https://ipywidgets.readthedocs.io/en/stable/user_install.html
  from .autonotebook import tqdm as notebook_tqdm
Repositorio: HuggingFaceTB/SmolLM2-135M-Instruct
Licencia   : apache-2.0
Descargas el último mes: 1.668.726

fichero                                    tamaño   para qué sirve
--------------------------------------------------------------------------------------
model.safetensors                          256.6 MB   LOS PESOS. Es el modelo.
tokenizer.json                               2.0 MB   cómo se parte el texto en tokens
vocab.json                                   0.8 MB   tabla token -> id
merges.txt                                   0.4 MB   reglas de fusión del tokenizador BPE
trainer_state.json                           0.1 MB
README.md                                    0.0 MB   la model card: licencia, datos de entrenamiento, limitaciones
training_args.bin                            0.0 MB   los hiperparámetros con los que lo entrenaron
tokenizer_config.json                        0.0 MB   incluye el chat template (plantilla de conversación)
.gitattributes                               0.0 MB
config.json                                  0.0 MB   arquitectura: capas, dimensiones, vocabulario
all_results.json                             0.0 MB
special_tokens_map.json                      0.0 MB   tokens especiales: fin de texto, relleno...
eval_results.json                            0.0 MB
train_results.json                           0.0 MB
generation_config.json                       0.0 MB   valores por defecto al generar

(+ 10 ficheros en subdirectorios: conversiones a ONNX y logs del entrenamiento original, que no usamos)
Fíjate en la proporción. El .safetensors es el 99 % del peso: eso son los números. Todo lo demás
son metadatos de unos pocos kilobytes que explican cómo usarlos.
safetensors frente a .bin: el formato antiguo de PyTorch (.bin) es un pickle de Python,
y un pickle puede ejecutar código arbitrario al abrirlo. safetensors es un formato de datos
puros que no puede ejecutar nada. Si te descargas pesos de un repositorio que no controlas, exige
safetensors.
# Descargamos y abrimos el modelo pequeño. La primera vez tarda lo que tarde
# la red; a partir de ahí sale de ~/.cache/huggingface y es instantáneo.
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

with cronometro("cargar SmolLM2-135M"):
    tok_p = AutoTokenizer.from_pretrained(MODELO_PEQUE)
    mod_p = AutoModelForCausalLM.from_pretrained(MODELO_PEQUE, dtype=DTYPE_ENTRENO)

cfg = mod_p.config
n_par = sum(p.numel() for p in mod_p.parameters())
print()
print(f"Parámetros            : {mil(n_par)}")
print(f"Capas (bloques)       : {cfg.num_hidden_layers}")
print(f"Dimensión del estado  : {cfg.hidden_size}")
print(f"Cabezas de atención   : {cfg.num_attention_heads}")
print(f"Vocabulario           : {mil(cfg.vocab_size)} tokens")
print(f"Contexto máximo       : {mil(cfg.max_position_embeddings)} tokens")
print(f"Ocupa en RAM          : {tam_mb(mod_p):.0f} MB en {DTYPE_ENTRENO}")
[cargar SmolLM2-135M] 1.2 s

Parámetros            : 134.515.008
Capas (bloques)       : 30
Dimensión del estado  : 576
Cabezas de atención   : 9
Vocabulario           : 49.152 tokens
Contexto máximo       : 8.192 tokens
Ocupa en RAM          : 513 MB en torch.float32
# Un modelo es una pila de bloques iguales. Mira dónde está el peso.
from collections import defaultdict

por_grupo = defaultdict(int)
for nombre, p in mod_p.named_parameters():
    if "layers." in nombre:
        grupo = "bloques transformer (× %d)" % cfg.num_hidden_layers
    elif "embed" in nombre:
        grupo = "tabla de embeddings"
    else:
        grupo = "otros (norma final, cabeza)"
    por_grupo[grupo] += p.numel()

for g, n in sorted(por_grupo.items(), key=lambda kv: -kv[1]):
    print(f"{g:32s} {mil(n):>14s}   {100 * n / n_par:5.1f} %")

print("\nLos nombres de los módulos de UN bloque (los que tocaremos con LoRA):")
for nombre, _ in mod_p.named_parameters():
    if nombre.startswith("model.layers.0."):
        print("   ", nombre)
bloques transformer (× 30)          106.202.880    79.0 %
tabla de embeddings                  28.311.552    21.0 %
otros (norma final, cabeza)                 576     0.0 %

Los nombres de los módulos de UN bloque (los que tocaremos con LoRA):
    model.layers.0.self_attn.q_proj.weight
    model.layers.0.self_attn.k_proj.weight
    model.layers.0.self_attn.v_proj.weight
    model.layers.0.self_attn.o_proj.weight
    model.layers.0.mlp.gate_proj.weight
    model.layers.0.mlp.up_proj.weight
    model.layers.0.mlp.down_proj.weight
    model.layers.0.input_layernorm.weight
    model.layers.0.post_attention_layernorm.weight
3. El tokenizador: el modelo no ve letras
Un modelo de lenguaje no procesa caracteres ni palabras. Procesa tokens, trozos de texto sacados de un vocabulario fijo. Entender esto explica media docena de comportamientos raros: por qué contar letras se le da mal, por qué el español cuesta más tokens que el inglés y por qué la factura de una API sube cuando escribes en catalán.
frase = "Banco Iberia concede hipotecas de hasta el 80 % del valor de tasación."

ids = tok_p(frase).input_ids
piezas = [tok_p.decode([i]) for i in ids]

print(f"Caracteres : {len(frase)}")
print(f"Tokens     : {len(ids)}")
print(f"Ratio      : {len(frase) / len(ids):.2f} caracteres por token\n")
print(" | ".join(repr(p)[1:-1] for p in piezas))
Caracteres : 70
Tokens     : 25
Ratio      : 2.80 caracteres por token

B | anco |  Iber | ia |  conced | e |  hip | ot | ec | as |  de |  hast | a |  el |   | 8 | 0 |  % |  del |  valor |  de |  t | as | ación | .
# El mismo contenido en tres idiomas. El vocabulario de casi todos los modelos
# está dominado por el inglés, y eso se paga en tokens, en dinero y en contexto.
textos = {
    "inglés":    "The bank grants mortgages of up to 80 % of the appraised value.",
    "español":   "El banco concede hipotecas de hasta el 80 % del valor de tasación.",
    "euskera":   "Bankuak tasazio-balioaren % 80ra arteko hipotekak ematen ditu.",
}
for idioma, t in textos.items():
    n = len(tok_p(t).input_ids)
    print(f"{idioma:10s} {n:3d} tokens para {len(t):3d} caracteres "
          f"({len(t) / n:.2f} car/token)")
inglés      17 tokens para  63 caracteres (3.71 car/token)
español     24 tokens para  66 caracteres (2.75 car/token)
euskera     27 tokens para  62 caracteres (2.30 car/token)
4. El chat template: lo que el modelo recibe de verdad
Cuando escribes en ChatGPT, lo que llega al modelo no es tu frase suelta. Es un texto plano con marcas que separan los turnos. Esas marcas se decidieron durante el entrenamiento y son distintas en cada familia de modelos.
El tokenizer trae la plantilla incrustada. Úsala siempre: construir el prompt a mano y
equivocarte en una marca degrada el modelo sin dar ningún error.
mensajes = [
    {"role": "system", "content": "Eres el asistente de Banco Iberia. Responde breve."},
    {"role": "user", "content": "¿Qué es una hipoteca a tipo variable?"},
]

crudo = tok_p.apply_chat_template(mensajes, add_generation_prompt=True, tokenize=False)
print("--- TEXTO QUE RECIBE EL MODELO (SmolLM2) ---")
print(crudo)
print("--- fin ---")
print(f"\n`add_generation_prompt=True` es lo que añade la última línea: le dice al")
print("modelo que es su turno. Sin eso, el modelo sigue escribiendo tu mensaje.")
--- TEXTO QUE RECIBE EL MODELO (SmolLM2) ---
<|im_start|>system
Eres el asistente de Banco Iberia. Responde breve.<|im_end|>
<|im_start|>user
¿Qué es una hipoteca a tipo variable?<|im_end|>
<|im_start|>assistant

--- fin ---

`add_generation_prompt=True` es lo que añade la última línea: le dice al
modelo que es su turno. Sin eso, el modelo sigue escribiendo tu mensaje.
5. Generar texto
Generar es repetir un paso muy simple: el modelo da una distribución de probabilidad sobre los ~49.000 tokens del vocabulario, se elige uno, se añade al final y se vuelve a empezar.
Cómo se elige ese token es lo único que cambia entre los modos de generación:
- greedy (
do_sample=False): siempre el más probable. Determinista. Sirve para tareas con una respuesta correcta, como clasificar. - muestreo con temperatura (
do_sample=True, temperature=T): se sortea. ConTbaja se parece al greedy; conTalta se vuelve creativo y luego incoherente.
# Miremos la distribución del primer token antes de elegir nada.
import torch

entrada = tok_p(crudo, return_tensors="pt", add_special_tokens=False)
with torch.no_grad():
    logits = mod_p(**entrada).logits[0, -1]       # logits del SIGUIENTE token

probs = torch.softmax(logits, dim=-1)
top = torch.topk(probs, 10)

print("Los 10 tokens más probables como primera palabra de la respuesta:\n")
for p, i in zip(top.values, top.indices):
    barra = "█" * int(p.item() * 60)
    print(f"  {repr(tok_p.decode([i]))[1:-1]:<16s} {p.item():6.2%}  {barra}")
Los 10 tokens más probables como primera palabra de la respuesta:

  A                35.50%  █████████████████████
  Un               12.06%  ███████
  La               11.35%  ██████
  El               10.05%  ██████
  The               3.40%  ██
  Qu                2.39%  █
  Es                2.34%  █
  In                2.19%  █
  E                 1.52%
  En                1.26%
# Ahora el modelo que de verdad habla español. 1,5 B en bfloat16 ocupa ~3 GB.
from transformers import AutoModelForCausalLM, AutoTokenizer

with cronometro("cargar Qwen2.5-1.5B"):
    tok_c = AutoTokenizer.from_pretrained(MODELO_CHARLA)
    mod_c = AutoModelForCausalLM.from_pretrained(
        MODELO_CHARLA, dtype=DTYPE_CHARLA, low_cpu_mem_usage=True)

print(f"\nParámetros : {mil(sum(p.numel() for p in mod_c.parameters()))}")
print(f"Ocupa      : {tam_mb(mod_c):.0f} MB en {DTYPE_CHARLA}")
print(f"             {tam_mb(mod_c) * 2:.0f} MB si lo cargásemos en float32")
[cargar Qwen2.5-1.5B] 1.3 s

Parámetros : 1.543.714.304
Ocupa      : 2944 MB en torch.bfloat16
             5889 MB si lo cargásemos en float32
def charlar(pregunta, sistema="Eres el asistente de Banco Iberia. Responde en dos frases.",
            max_new_tokens=90, temperatura=None):
    """Genera una respuesta con Qwen. `temperatura=None` significa greedy."""
    msgs = [{"role": "system", "content": sistema},
            {"role": "user", "content": pregunta}]
    texto = tok_c.apply_chat_template(msgs, add_generation_prompt=True, tokenize=False)
    ent = tok_c(texto, return_tensors="pt", add_special_tokens=False).to(mod_c.device)
    kw = dict(do_sample=False) if temperatura is None else dict(
        do_sample=True, temperature=temperatura, top_p=0.95)
    with torch.no_grad():
        salida = mod_c.generate(**ent, max_new_tokens=max_new_tokens,
                                pad_token_id=tok_c.eos_token_id, **kw)
    nuevos = salida[0, ent.input_ids.shape[1]:]
    return tok_c.decode(nuevos, skip_special_tokens=True).strip()


with cronometro("generar"):
    print(charlar("¿Qué es una hipoteca a tipo variable?"))
The following generation flags are not valid and may be ignored: ['temperature', 'top_p', 'top_k']. Set `TRANSFORMERS_VERBOSITY=info` for more details.
Una hipoteca a tipo variable, también conocida como hipoteca flexible o hipoteca con tipos dinámicos, es un tipo de préstamo financiero que permite al cliente elegir entre diferentes tipos de interés durante la duración del contrato. Esto puede incluir tipos de interés fijos,浮动利率, y otros tipos de interés variables. La flexibilidad en los tipos de interés se presenta como ventaja para aquellos que buscan minimizar
[generar] 8.6 s
# El efecto de la temperatura, con la misma pregunta tres veces.
fijar_semilla()
pregunta = "Escribe un eslogan para la nueva cuenta nómina de Banco Iberia."

for T in [None, 0.7, 1.5]:
    etiqueta = "greedy" if T is None else f"T = {T}"
    print(f"\n[{etiqueta}]")
    print("  ", charlar(pregunta, max_new_tokens=40, temperatura=T).replace("\n", " "))
[greedy]
   "Un paso más hacia tu economía sostenible con Banco Iberia".

[T = 0.7]
   "Confía en nuestros sistemas, confía en tu futuro."

[T = 1.5]
"Trabaja, financiástage una vida más cómoda".
6. El límite: lo que el modelo no puede saber
Banco Iberia está inventado. Sus documentos no existen en internet, así que ningún modelo los ha visto durante el preentrenamiento. Preguntémosle de todas formas.
print(charlar("¿Cuál es la comisión exacta por sacar dinero en un cajero de otro "
              "banco español según la normativa de Banco Iberia?",
              max_new_tokens=110))
Lo siento, pero no tengo acceso a información específica sobre las comisiones bancarias o regulaciones específicas de cada entidad financiera como Banco Iberia. Para obtener esta información precisa y actualizada, te recomendaría que consultes directamente con el banco o busques en su página web oficial los detalles más recientes.
Léelo con atención. Puede que haya dicho que no lo sabe, y eso sería lo correcto. Pero lo normal es que haya dado una cifra con tono seguro, o una explicación genérica que suena a respuesta sin serlo.
Esto no es un fallo que se arregle con un prompt mejor. El modelo está haciendo exactamente aquello para lo que se le entrenó: continuar el texto de la manera más plausible. "Plausible" y "cierto" coinciden casi siempre cuando el dato estaba en el preentrenamiento, y dejan de coincidir en cuanto preguntas por algo que no estaba.
La respuesta real, que está en el Catálogo de Productos Minoristas de Banco Iberia, es 1,95 €
por operación. Vamos a hacer que el modelo la lea en vez de inventarla: eso es el cuaderno 01.
7. Ejercicios
0.1 Cambia MODELO_CHARLA en comun/config.py por Qwen/Qwen2.5-0.5B-Instruct y repite la
sección 5. ¿Cuánto se degrada el español al bajar de 1,5 B a 0,5 B? ¿Y cuánto gana en velocidad?
0.2 La ratio caracteres/token del español sale peor que la del inglés. Calcula, para un servicio que procese 10 millones de mensajes de clientes al mes a 0,15 € por millón de tokens de entrada, cuánto cuesta esa diferencia al año.
0.3 Sube la temperatura a 2.5 y genera veinte veces. Describe en qué momento exacto el texto
deja de ser español. Explica por qué pasa mirando lo que hace softmax(logits / T) cuando T crece.
0.4 Usa tok_p.apply_chat_template y tok_c.apply_chat_template sobre los mismos mensajes y
compara los dos textos crudos. Son dos familias distintas de modelo. ¿Qué marcas usa cada una?
0.5 Monta el prompt a mano, sin la plantilla, escribiendo tú <|im_start|>user ... con una
marca mal escrita. Genera y describe cómo se degrada la respuesta. Este es el error silencioso más
caro que se comete al servir un modelo propio.